
9 min de leitura
Diretor de uma das maiores empresas de tecnologia do mundo chamou de possivelmente “o maior roubo de trabalho da história da humanidade” o que foi feito para treinar a inteligência artificial que milhões usam todo dia, e a empresa dele está entre as processadas
Escrito por Bruno Teles
Publicado em 19/09/2026 às 12:40
Ciência e Tecnologia
Canal
Seja o primeiro a reagir!
Prefira o CPG no Google
Um diretor da Microsoft escreveu, em documento interno, que a coleta de textos para treinar a inteligência artificial seria vista como “um roubo impressionante de proporções sem precedentes”; a frase veio a público em setembro de 2026, no processo em que o New York Times acusa a própria Microsoft e a OpenAI, dona do ChatGPT
Brent Hecht, diretor de Ciência Aplicada da Microsoft, escreveu num documento interno que a coleta de textos para treinar a inteligência artificial seria vista como “um roubo impressionante de proporções sem precedentes”, e a frase ficou pública em 17 de setembro de 2026.
Ela não apareceu numa entrevista nem num palco, e sim no processo que o New York Times move desde dezembro de 2023 contra a OpenAI, dona do ChatGPT, e contra a Microsoft, parceira e investidora dela desde 2019.
O autor da frase trabalha justamente numa das empresas processadas, e o jornal fez questão de pôr as palavras dele logo na primeira linha do pedido que entregou ao juiz.
ARTIGO CONTINUA ABAIXO
Veja também
Procurada pela agência France Presse, a Microsoft respondeu que as declarações representam “a opinião pessoal de um funcionário” e “não refletem a posição da empresa”, relata o g1.
A frase do diretor da Microsoft, palavra por palavra
O documento é o memorial em que o New York Times e outros veículos pedem ao juiz federal Sidney Stein uma sentença sumária, isto é, uma decisão sem passar por julgamento, e a versão pública, com parte das tarjas pretas retiradas, está no CourtListener, o arquivo aberto de processos dos Estados Unidos.
Estas são as frases atribuídas a Hecht no memorial, em inglês e em tradução livre:
No texto em inglês, o “perhaps” (possivelmente) vem fora das aspas, então quem escreve “perhaps the largest theft of labor in human history” são os advogados do jornal, e a expressão entre aspas é a que o memorial atribui ao diretor.
A primeira frase, lida inteira, também é uma previsão, porque nela, segundo o memorial, Hecht afirma como “milhões de pessoas” iriam enxergar os modelos de inteligência artificial devorando o trabalho delas.
Quem é o homem da Microsoft que virou peça do processo
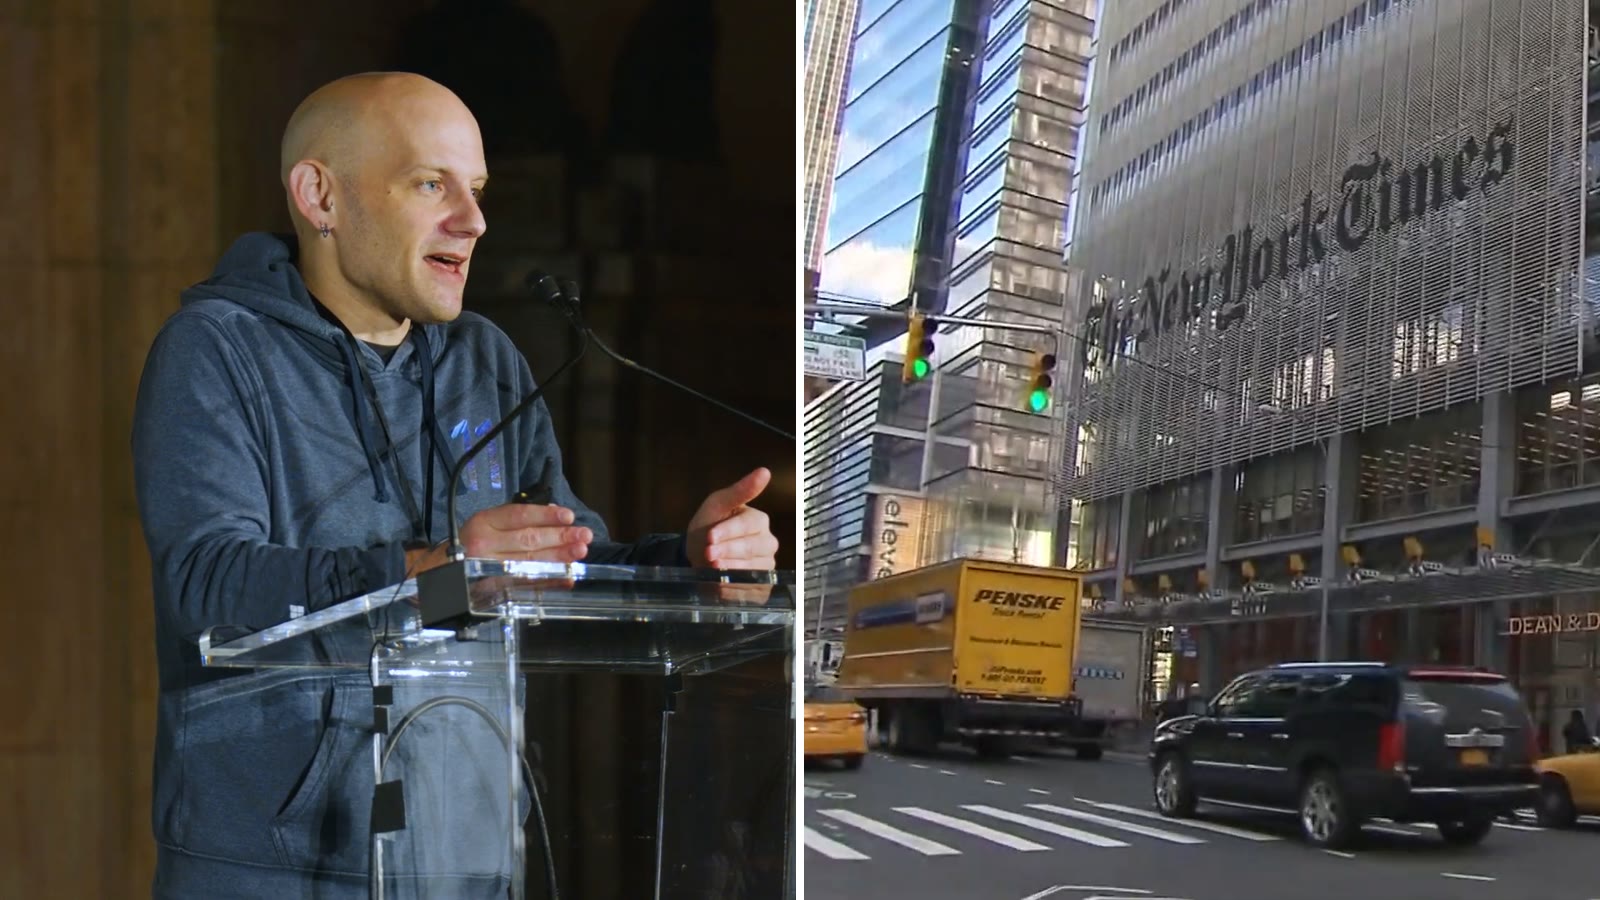
Hecht não é um nome qualquer no assunto, e num vídeo publicado em dezembro de 2024 pelo canal da empresa Valence ele conta que entrou na Microsoft em 2019, vindo da Universidade Northwestern, onde era professor, com a missão de “inventar o futuro do trabalho”.
Na palestra, ele apresenta “cinco equívocos” sobre a inteligência artificial generativa, e o quarto, escrito no slide, é a ideia de que a tecnologia seria “inerentemente ruim para quem vive de produzir conteúdo”.
Ele pula esse item por falta de tempo, mas resume o que pensa, dizendo que, para organizações e pessoas que fazem conteúdo, a IA generativa “pode ser um grande benefício, em vez de algo ameaçador”, um assunto que, contou, é “próximo do coração” e da pesquisa dele.
Assista o vídeo
O que o New York Times acusa a OpenAI e a Microsoft de fazer
O jornal afirma que as duas empresas copiaram “milhões” de reportagens inteiras, sem permissão, para criar produtos comerciais que substituem o próprio jornalismo, e que a OpenAI teria extraído conteúdo de mais de 10 milhões de artigos, quase um terço do Times, informa o g1.
O memorial detalha as alegações e diz que só os conjuntos de dados usados numa fase do treino chamada de “mid-training” têm mais de 91.692 cópias de obras dos autores da ação.
Outro conjunto, montado com dados de um projeto chamado Mango, teria cópias de pelo menos 160.903 obras dos veículos, e o jornal também acusa a OpenAI de retirar dos textos os avisos de direitos autorais antes do treino.
E tem a troca de mensagens mais citada nos Estados Unidos, de quando um pesquisador contou ao presidente da OpenAI, Greg Brockman, sobre “um truque para driblar o paywall do nytimes”, e a resposta registrada no memorial foi curta: “ah nice” (“ah, legal”).
Tudo isso, por enquanto, é acusação do jornal e dos outros veículos, porque nenhum juiz decidiu ainda se essas cópias violaram a lei.
A defesa da OpenAI e da Microsoft: o uso legítimo
A OpenAI e a Microsoft alegam que usar conteúdo do Times está amparado pelo “fair use”, o uso legítimo, uma exceção da lei americana de direitos autorais que permite usar obras sem consentimento em certas situações, relata o g1. As empresas também afirmam que treinar a IA transforma o conteúdo usado.
A Microsoft não ficou só na defesa, e em documento público de 18 de setembro de 2026 lista os fatos que, na visão dela, sustentam o próprio pedido de sentença sumária, com o “fair use” como primeiro argumento.
As empresas ganharam ainda um aliado de peso no início de setembro de 2026, quando o Departamento de Justiça dos Estados Unidos apresentou parecer a favor das duas, citando o “progresso científico”, o crescimento econômico e a “segurança nacional”, informa o g1.
Cliques até 93% menores: o “círculo vicioso” que a própria Microsoft mediu
O ponto que mais pesa contra o “fair use” é a substituição, porque se o robô entrega a notícia o leitor não vai ao jornal, e segundo o memorial a Microsoft mediu isso.
Segundo os dados da empresa citados pelo jornal, o Copilot derrubou de 83% a 93% os cliques para os sites do Times e do Daily News, em comparação com a busca tradicional do Bing, e nos sites do grupo Ziff Davis a queda foi de 51% a 94%.
Na prática, onde a busca comum mandava 100 cliques para o jornal, a resposta do Copilot mandava de 7 a 17.
Um documento que o memorial atribui a Hecht deu nome ao fenômeno: “Nossa estratégia de conteúdo para IA iniciou um ‘círculo vicioso’ que vai prejudicar o desempenho dos nossos modelos e da web inteira ao mesmo tempo”, diz o texto citado.
Até o Google entrou na conta, já que um especialista contratado pela OpenAI afirmou, com base num estudo do Instituto Reuters de 2026, que as visitas enviadas a sites de notícias pelo Google Discover caíram de mais de 5 bilhões por mês para menos de 4 bilhões depois dos resumos feitos por inteligência artificial.
Linha do tempo da briga do New York Times com a inteligência artificial da OpenAI
- 2019: a Microsoft faz o primeiro investimento na OpenAI;
- fim de 2022: o ChatGPT é lançado;
- 27/12/2023: o New York Times entra com a ação num tribunal federal de Nova York;
- março e abril de 2025: o juiz Sidney Stein rejeita a maior parte dos pedidos para arquivar o caso;
- abril de 2025: os processos contra a OpenAI são reunidos num só, o 25-md-3143;
- 13/05/2025: a juíza Ona Wang manda a OpenAI guardar os registros de conversas que seriam apagados;
- 09/10/2025: termina a obrigação de guardar novos registros;
- 07/11/2025: a juíza manda entregar 20 milhões de registros de conversas do ChatGPT, sem identificação dos usuários;
- início de setembro de 2026: o Departamento de Justiça apoia as empresas;
- 04/09/2026: o jornal e outros veículos pedem sentença sumária;
- 17/09/2026: sai a versão pública do memorial com as frases de Hecht.
O que está em jogo: bilhões de dólares e o próprio modelo de inteligência artificial
Na ação original, de dezembro de 2023, o New York Times diz querer responsabilizar as empresas pelos “bilhões de dólares” em indenizações que estariam devendo pela cópia de suas obras.
O pedido final da ação vai além do dinheiro, porque o jornal pede que a Justiça mande destruir todos os modelos GPT e conjuntos de treino que incorporem obras do Times.
No memorial de setembro, os veículos pedem indenização separada para cada artigo usado, e o valor total ainda não está claro, informa o g1, mas a lei americana prevê de US$ 750 a US$ 30 mil por obra, e até US$ 150 mil quando a violação é intencional.
O que muda para quem usa ChatGPT e Copilot no Brasil
O processo corre nos Estados Unidos e será decidido pela lei americana, e a decisão do juiz Stein sobre o pedido de sentença sumária não é esperada antes de 2027, relata o g1.
Mas o caso já esbarrou no dia a dia de quem conversa com robôs. Por ordem da juíza Ona Wang, a OpenAI teve de guardar, entre maio e outubro de 2025, registros de conversas do ChatGPT que seriam apagados, e depois foi mandada entregar 20 milhões deles, sem identificação, aos advogados dos jornais.
O Brasil tem a sua própria briga, já que a Folha de S.Paulo processou a OpenAI na Justiça de São Paulo em agosto de 2025, acusando o ChatGPT de usar reportagens sem autorização e sem pagamento.
Por aqui a regra ainda não saiu do papel, e o projeto de lei 2338/2023, que regula a inteligência artificial e trata de remuneração a quem tem obras usadas no treino, passou pelo Senado em dezembro de 2024 e, em setembro de 2026, aguardava parecer na Câmara.
A reportagem de TV e o post que espalharam o documento
O caso começou a ganhar o noticiário em dezembro de 2023, quando emissoras americanas mostraram a sede do New York Times, em Nova York, e explicaram o que o jornal pedia contra a OpenAI e a Microsoft.
Assista o vídeo
Quase três anos após a ação, em 17 de setembro de 2026, foi um post no X que fez o memorial circular, quando Jason Kint, executivo-chefe da Digital Content Next, associação de editores digitais, publicou o trecho com a frase de Hecht destacada em rosa.
A frase do diretor da Microsoft agora está nos autos, a Microsoft diz que ela não fala pela empresa e a OpenAI se apoia no “fair use”. Quem decide se foi roubo ou uso legítimo é o juiz Sidney Stein, e a resposta dele só deve vir em 2027.
Tags
inteligencia artificial
Conteúdo reproduzido originalmente em: clickpetroleoegas por Bruno Teles.