
8 min de leitura
Startup avaliada em US$ 2 bilhões conecta novo chip Raptor à infraestrutura da Nvidia e prepara servidores de IA para 2027 focados em chatbots, programação e agentes de voz
Escrito por Roberta Souza
Publicado em 13/09/2026 às 07:27
Atualizado em 13/09/2026 às 07:54
Ciência e Tecnologia
Canal
Seja o primeiro a reagir!
Prefira o CPG no Google
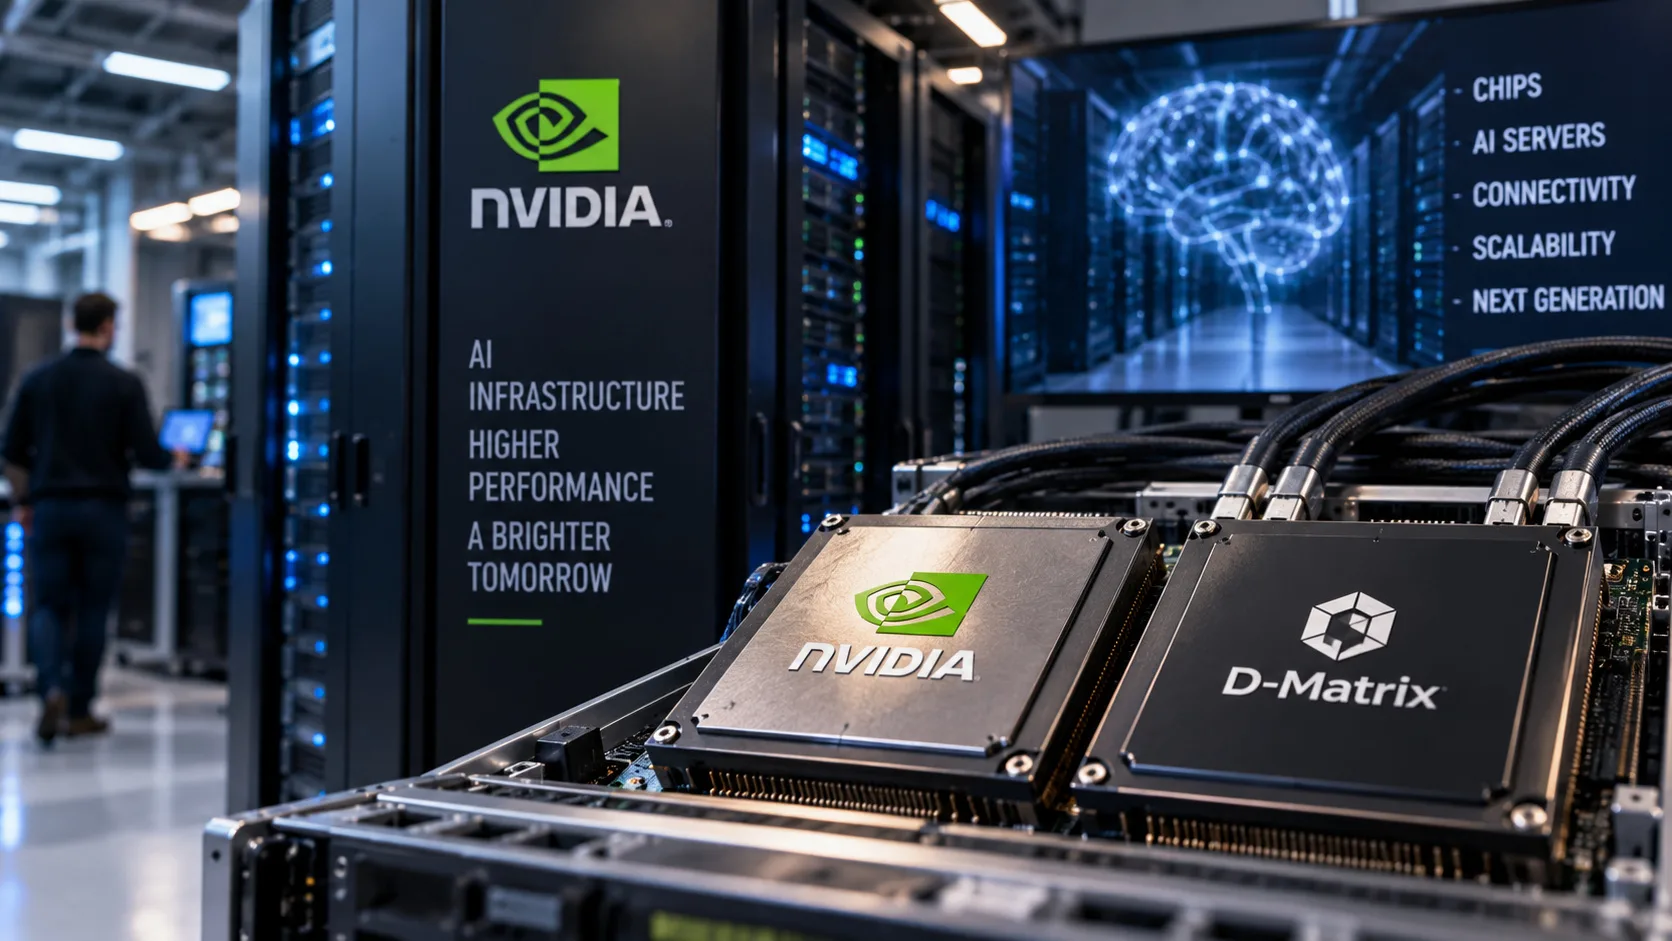
A d-Matrix vai integrar seus processadores Raptor, especializados em inferência de inteligência artificial, à arquitetura de servidores da Nvidia usando NVLink Fusion. A parceria abre caminho para sistemas mistos de chips dentro das mesmas “fábricas de IA”, enquanto a startup apoiada pela Microsoft tenta disputar uma etapa do mercado que cresce conforme modelos deixam o treinamento e passam ao uso diário.
A startup norte-americana d-Matrix decidiu usar uma das tecnologias centrais da Nvidia para colocar seus próprios processadores dentro da infraestrutura de data centers da gigante dos chips. O acordo envolve o NVLink Fusion, sistema de interconexão que permitirá integrar a próxima geração de aceleradores Raptor diretamente à arquitetura de racks MGX da Nvidia.
Segundo a Reuters, os primeiros sistemas compatíveis estão previstos para 2027, enquanto a d-Matrix espera concluir ainda em 2026 o estágio final de projeto do Raptor. A tecnologia mira principalmente uma fase da inteligência artificial que cresce rapidamente: a inferência, quando modelos já treinados precisam responder usuários, gerar códigos, conversar em tempo real ou operar agentes de voz.
ARTIGO CONTINUA ABAIXO
Veja também
Recomendado para você
Economia
Produtores de pimenta do Espírito Santo ganham fábrica de R$ 45 milhões capaz de esterilizar 2.520 quilos de especiarias por hora e atender exportadores da América Latina
Produtores de pimenta do Espírito Santo ganham uma fábrica de R$ 45 milhões capaz de esterilizar 2.520 quilos de especiarias por hora e atender exportadores da América Latina.
A Technobras inaugurou…
Paulo Nogueira
0
A movimentação é relevante porque a d-Matrix não pretende substituir toda a infraestrutura da Nvidia. Pelo contrário: a startup quer colocar seus chips especializados dentro do ecossistema que a própria Nvidia construiu, aproveitando racks, rede, refrigeração e cadeia de fornecedores já utilizadas nos grandes data centers.
Nvidia abre sua infraestrutura para chips desenvolvidos por outras empresas
Durante anos, a força da Nvidia esteve associada não apenas às GPUs, mas ao conjunto completo de hardware, redes e software necessário para operar sistemas de inteligência artificial em larga escala.
Agora, o NVLink Fusion amplia esse modelo.
A tecnologia permite que processadores desenvolvidos por terceiros utilizem a infraestrutura de interconexão da Nvidia. Assim, fabricantes especializados conseguem conectar seus próprios chips aos racks MGX e à rede de alta velocidade da companhia sem reconstruir todo o sistema ao redor de uma arquitetura independente.
A mudança se encaixa em uma disputa que o CPG já acompanha. A análise sobre como a Nvidia construiu a infraestrutura da inteligência artificial e passou a enfrentar Huawei, TPUs do Google, startups e clientes que procuram alternativas às GPUs mais caras mostrou que o desafio da empresa deixou de ser simplesmente vender processadores.
Agora, a Nvidia também tenta manter sua tecnologia como padrão de infraestrutura, inclusive quando outro fabricante fornece parte do poder de processamento.
Raptor será especializado em inferência, não apenas no treinamento dos modelos
Existe uma diferença importante entre treinar uma inteligência artificial e executar o modelo depois que ele já está pronto.
O treinamento de grandes modelos exige enorme capacidade computacional e consolidou as GPUs da Nvidia como peça central do mercado. A inferência ocorre posteriormente, quando milhões de usuários começam a fazer perguntas, gerar textos, pedir códigos ou interagir com agentes de IA simultaneamente.
É justamente nessa segunda etapa que a d-Matrix se especializou.
Seu novo Raptor foi projetado para aplicações sensíveis à latência, como assistentes de programação, chatbots em tempo real e agentes de voz. Nesses serviços, não basta processar grandes volumes de informação: a resposta precisa chegar rapidamente ao usuário.
A estratégia mostra como a indústria de chips começa a se fragmentar por tipo de trabalho.
Em vez de um único processador executar todas as etapas da IA, diferentes aceleradores podem assumir tarefas específicas dentro do mesmo data center.
Nvidia e d-Matrix querem misturar diferentes chips no mesmo sistema
A própria d-Matrix descreve uma arquitetura na qual seus XPUs podem trabalhar ao lado de sistemas Nvidia baseados na futura plataforma Vera Rubin.
Um exemplo está na geração de código por inteligência artificial.
A parte inicial da consulta, conhecida como prefill, pode permanecer nas GPUs, que lidam bem com o processamento computacional intensivo. Depois, a fase de decode, responsável pela geração sequencial das respostas, pode migrar para processadores Raptor especializados em baixa latência.
Na prática, isso permite que o operador do data center escolha qual tipo de chip executará cada parte da tarefa.
Consequentemente, a disputa deixa de ser apenas “GPU contra outro chip”.
O novo modelo pode colocar GPUs e aceleradores especializados trabalhando juntos dentro da mesma fábrica de IA.
Novo chip combina memória e processamento em uma estrutura 3D
A arquitetura do Raptor também tenta atacar um problema fundamental dos chips modernos: movimentar dados entre memória e processamento consome tempo e energia.
A d-Matrix afirma que o processador usará uma abordagem de empilhamento 3D, combinando uma camada de memória DRAM com um chip de computação SRAM dentro de um mesmo conjunto.
A proposta aproxima fisicamente memória e processamento.
Com isso, a empresa pretende reduzir a quantidade de movimentações necessárias para gerar respostas de IA e, consequentemente, diminuir latência e consumo de energia.
O Raptor sucede a plataforma Corsair, primeira geração comercial da d-Matrix destinada à inferência. A startup afirma que seus novos processadores estão sendo avaliados por grandes laboratórios de IA e operadores de infraestrutura de nuvem.
No entanto, essa informação vem da própria empresa e ainda não equivale a contratos comerciais divulgados com esses clientes.
Sistemas também usarão CPU Vera, BlueField-4 e Spectrum-X
A integração vai além do NVLink.
Os racks planejados pela d-Matrix devem incorporar diversas tecnologias do ecossistema Nvidia, incluindo CPUs Vera, BlueField-4 DPUs, ConnectX-9 SuperNICs e redes Spectrum-X Ethernet.
Assim, a startup poderá concentrar seu desenvolvimento no acelerador de inferência enquanto utiliza peças já disponíveis da arquitetura Nvidia para comunicação, gerenciamento de dados e conexão entre servidores.
Essa abordagem reduz uma barreira importante para fabricantes menores de semicondutores.
Construir um chip competitivo é apenas parte do problema. Para colocar centenas deles dentro de um data center, também é necessário desenvolver racks, sistemas de alimentação, refrigeração, rede, software, conectores e cadeia de fornecimento.
Com o NVLink Fusion, a d-Matrix tenta evitar construir toda essa infraestrutura do zero.
Servidores refrigerados a líquido já mostram para onde o mercado está indo
O avanço ocorre enquanto servidores de IA ficam cada vez mais densos e exigem novas soluções de refrigeração.
Em agosto, o CPG mostrou como Cisco, Supermicro e Nvidia passaram a combinar servidores de alta densidade e refrigeração líquida para operar modelos com trilhões de parâmetros. A nova arquitetura da d-Matrix seguirá a mesma direção ao utilizar o ecossistema MGX preparado para sistemas de grande densidade computacional.
Isso mostra que a competição por inteligência artificial deixou de se concentrar apenas no desempenho individual dos chips.
Energia, resfriamento, memória e comunicação entre processadores passaram a determinar quanto trabalho um data center consegue realmente executar.
Primeiro rack com Raptor está previsto para o quarto trimestre de 2027
A Reuters informa de maneira geral que os sistemas devem ficar disponíveis em 2027. A própria d-Matrix fornece um cronograma mais específico e projeta a disponibilidade inicial dos Raptor integrados aos racks MGX para o quarto trimestre de 2027.
Antes disso, a empresa pretende concluir o chamado tape-out do Raptor até o fim de 2026.
Esse estágio representa a conclusão do projeto que será enviado para fabricação do silício. Depois vêm produção, encapsulamento, validação e integração aos sistemas finais.
Portanto, ainda existe um caminho técnico relevante entre o anúncio e a implantação comercial em larga escala.
Startup chegou a US$ 2 bilhões de avaliação após rodada de US$ 450 milhões
A d-Matrix também chega à parceria com mais capital para acelerar sua expansão.
Segundo a Reuters, a companhia levantou US$ 450 milhões em 2025, operação que levou sua avaliação para aproximadamente US$ 2 bilhões. Antes disso, a Microsoft já havia participado de uma rodada de US$ 110 milhões em 2023.
A startup enviou seu primeiro chip de inteligência artificial ao mercado no final de 2024.
Agora, tenta avançar de aceleradores isolados para infraestrutura completa de racks.
Essa evolução coincide com a corrida global por novas fábricas de IA. O CPG mostrou que a Nvidia fechou acordos na Coreia do Sul para ampliar fábricas de IA, data centers e infraestrutura avançada com horizonte até 2027, mostrando que o crescimento desse mercado depende cada vez mais da montagem de sistemas completos, e não apenas da fabricação de chips.
Astera Labs também participará da arquitetura
Há ainda uma terceira empresa envolvida diretamente no projeto.
A Astera Labs trabalhará com a d-Matrix em soluções de conectividade destinadas a garantir a movimentação de dados em alta velocidade dentro dos sistemas.
Esse componente é crítico porque colocar dezenas ou centenas de aceleradores dentro de um rack só produz ganho real quando os chips conseguem trocar dados rapidamente.
Se a comunicação se torna lenta, parte da capacidade computacional permanece ociosa.
Por isso, tecnologias de interconexão como NVLink ganharam importância estratégica semelhante à dos próprios processadores.
A estratégia pode fortalecer concorrentes sem tirar a Nvidia do centro
À primeira vista, permitir que chips de terceiros entrem nos racks poderia parecer uma ameaça à Nvidia.
Contudo, existe outra leitura.
Quando uma startup como a d-Matrix adota NVLink, MGX, Spectrum-X, BlueField e CPUs Vera, ela também passa a depender de uma parcela importante da infraestrutura Nvidia. Dessa forma, mesmo quando o processamento não acontece exclusivamente em GPUs da companhia, boa parte do sistema continua utilizando sua tecnologia.
É uma estratégia que pode ampliar o ecossistema da Nvidia justamente no momento em que grandes empresas procuram chips especializados.
Em vez de exigir que todos utilizem apenas GPUs, a empresa pode tentar fazer com que qualquer acelerador alternativo continue conectado à sua plataforma.
Inferência pode se tornar a próxima grande disputa dos chips de IA
O acordo também revela uma mudança no mercado.
Durante a primeira fase da corrida pela inteligência artificial generativa, boa parte do investimento se concentrou no treinamento dos modelos. Agora, milhões de usuários e empresas utilizam esses sistemas diariamente, o que transfere uma parcela crescente do custo para a inferência.
Chatbots precisam responder perguntas. Assistentes de programação precisam gerar código. Agentes precisam executar tarefas. Sistemas de voz precisam reagir quase instantaneamente.
Cada interação consome capacidade computacional.
Por isso, fabricantes procuram chips capazes de produzir mais respostas, com menor latência e menor consumo energético.
A d-Matrix aposta justamente nesse gargalo.
Ao mesmo tempo, a Nvidia tenta garantir que, mesmo quando um concorrente execute parte desse processamento, o data center continue construído ao redor de sua infraestrutura.
A arquitetura prevista para 2027 será um dos testes dessa estratégia: Raptor no processamento especializado, tecnologias Nvidia conectando o sistema e diferentes tipos de chips trabalhando dentro da mesma fábrica de IA.
E você, acredita que permitir chips concorrentes dentro da própria infraestrutura vai fortalecer ainda mais a Nvidia ou abrir espaço para que startups reduzam gradualmente a dependência das GPUs?
Fonte
Reuters
Conteúdo reproduzido originalmente em: clickpetroleoegas por Roberta Souza.